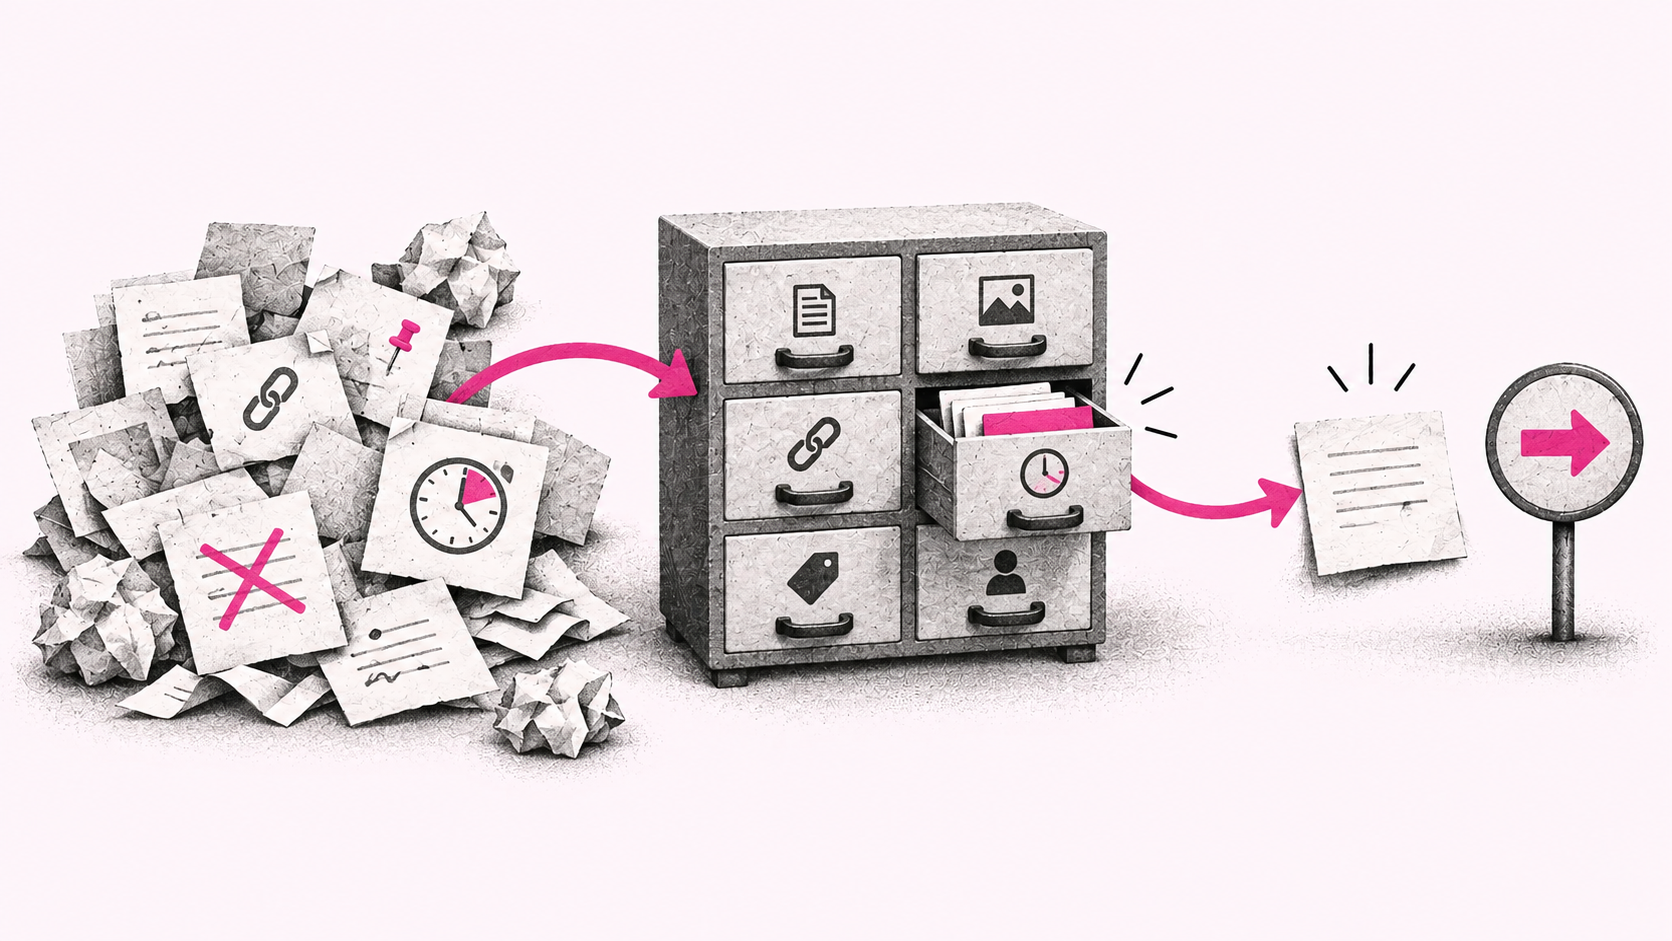
Pojďme si nejdřív ujasnit, co ten second brain vlastně je. Mluví se o něm na konferencích, na fórech, vznikají o něm články i videa. V AI světě je to jedno z hodně probíraných témat. Já second brain beru jako knihovnu. A nemyslím tím knihovnu, kterou máte doma na zdi, ale třeba městskou knihovnu. Přijdete dovnitř, máte tam různé regály a podle toho, co hledáte, se vydáte do příslušné části. Procházíte ji a dohledáváte informace, které potřebujete. Podobně může vypadat i hledání ve vašich dokumentech, poznámkách a rozhodnutích.
Existují systémy, které umožňují takhle procházet obrovské množství informací. Jenže pro spoustu lidí a narovinu i pro spoustu malých firem je zbytečné začínat takovým řešením. Místo toho, aby AI začali používat při práci a posouvali svůj business, řeší, jakou vybrat vektorovou databázi a jestli by to s další technologií nešlo postavit ještě líp. Za mě je tohle bullshit. Pokud pro tu složitost nemám konkrétní důvod, není to cesta, kterou bych si vybral nebo doporučoval svým klientům. U větší firmy, která má spoustu procesů a velké množství informací, může být takové řešení potřeba. Pro řadu menších firem a jednotlivců je to ale kanon na vrabce. V tomhle článku proto ukážu, jak jsem si second brain postupně stavěl já a jak nad ním přemýšlím.
Všechny informace už někde máte
Když jsem začal pracovat na svém AI systému, kterému dnes říkám Radek OS, neseděl jsem nad papírem a nerozkresloval si, jak má vypadat můj vlastní operační systém. Celé to vznikalo hodně organicky. S AI jsem pracoval často a řešil s ní spoustu věcí. Jenže se mi pravidelně stávalo, že jsem něco vysvětloval podruhé, znovu upřesňoval zadání nebo ji naváděl, kde najde tenhle a tamten dokument. A to mě na rovinu nebavilo. Nechtěl jsem pořád opakovat něco, co už jsme spolu jednou vyřešili.
V tu chvíli jsem používal Notion jako svůj hlavní zápisník. Měl jsem tam poznámky o klientech, osobní věci, transkripty schůzek a další informace. Když jsem si potřeboval něco zapsat a rozhodl se to zapsat, šlo to do Notionu. Vedle toho jsem měl Gmail, Google dokumenty a tabulky na Drivu, vlastní CRM a Slack. Napříč těmito nástroji jsem byl schopný dohledat prakticky všechno, co jsem k práci potřeboval. A když tam nějaká informace nebyla, tak jsem ji s největší pravděpodobností prostě neměl zapsanou.
Pro mě tedy otázka byla, jak tohle všechno zpřístupnit AI, aby s tím mohla co nejrychleji a nejefektivněji pracovat. Nechtěl jsem přidávat další systém ani jí pokaždé posílat odkazy na jednotlivé dokumenty. Chtěl jsem třeba říct: „Hele, otevřeme poslední dvě nabídky, které jsme posílali tomu klientovi,“ a být schopný je s ní rovnou projít a probrat.
Jak jsem si nastavil první verzi
Nechtěl jsem kvůli tomu vybírat novou aplikaci, takže jsem šel po nejjednodušším, vlastně nejblbějším řešení, které jsem měl po ruce. V Notionu jsem vytvořil část pro svůj second brain. Jeho výhoda pro mě byla v databázích. Nepracuju s nimi stejně jako s databázemi u klientů nebo na vlastních projektech. Beru je trochu jako Excel na steroidech, ve kterém si můžu postavit content kalendář, CRM nebo seznam úkolů. Pro to, co jsem tehdy potřeboval, mi ta volnost a jednoduchost vyhovovala.
S AI jsem probral, co potřebuju, nechal ji projít moje dokumenty a Notion a navrhnout, jak se v tom bude orientovat. Neřešil jsem u toho embeddingy. Základním stavebním kamenem se stala jedna logová databáze, do které se zapisovalo, co se dělo a co jsme rozhodli. Kdy jsme vydali článek, kdy jsme poslali klientovi nabídku, co jsme upravili nebo jakou novou verzi nasadili. Kolem toho pak postupně přibývaly další věci podle toho, co jsme při práci potřebovali.
Samostatná databáze všech dokumentů přitom vůbec nevznikla, protože jsem ji nepotřeboval. Stavěl jsem si second brain pro sebe, ne produkční systém, který musí dohledávat informace ve zlomku sekundy. A za mě je i pro interní použití ve spoustě firem důležitější nejdřív vědět, kdo co řekl, co jsme kdy rozhodli a jaká změna se skutečně udělala. Mít po ruce tenhle log rozhodnutí a činností pro mě bylo důležitější než od začátku ladit technologii vyhledávání.
Propojení všeho na jednu hromadu
Aby second brain mohl fungovat, potřebuje agent přístup k dokumentům a informacím, se kterými chcete pracovat. Je jedno, jestli máte úkoly v Asaně, poznámky v Notionu nebo používáte úplně jiný systém. K čemu chcete, aby se AI dostala, k tomu jí ten přístup musíte dát. Přes to nejede vlak.
První krok je tedy napojit nástroje, které používáte, přes dostupné MCP konektory a pluginy. Teď nemyslím rozšíření do prohlížeče, ale napojení přímo v AI nástroji. Já osobně používám ChatGPT, s nástroji od Anthropicu nepracuju, takže popisuju svoji cestu přes ChatGPT. Potřebná napojení jsem už naštěstí měl připravená.
Tam, kde potřebujete jen čtení, dejte agentovi přístup jen ke čtení. Já AI používám i k vykonávání práce, takže kde to jde, mám povolený také zápis. V instrukcích pak vymezuju, co dělat smí a co ne. Třeba e-mail mi může připravit, ale nesmí ho odeslat. To je moje nastavení podle toho, jak s AI pracuju.
Když jsem měl napojení a první strukturu v Notionu, nechal jsem AI projít moje konverzace za posledních čtrnáct dní a podívat se do dokumentů. Chtěl jsem zrekonstruovat log toho, na čem jsem pracoval a co se rozhodlo. Mohl jsem jít dál do minulosti, ale na rovinu se mi nechtělo. Pro to, co jsem v tu chvíli potřeboval, mi to přišlo zbytečné.
Jakmile jsem měl nástroje napojené, základní strukturu databází v Notionu a doplněný log, bylo v zásadě hotovo.
První verze je teprve začátek
V tu chvíli měla moje AI přístup k dokumentům, e-mailům a dalším systémům a v Notionu jsem měl strukturu, která odpovídala tomu, jak jsem chtěl second brain používat. Nezbývalo než s tím začít pracovat. Zvlášť když si to stavíte sami pro sebe, těžko jinak zjistíte, jestli to funguje. Potřebujete systém dlouhodobě používat a sledovat, jaké informace vám vrací.
Jako freelancer nebo menší firma máte pravděpodobně velkou část práce v hlavě. Víte, co jste s klientem řešili, na čem jste se domluvili a jak běží zakázky. Když vám pak AI vrátí informaci, o které víte, že už neplatí, většinou si toho všimnete. V tu chvíli bych ale nechtěl skončit u toho, že jí řeknu: „Tohle není správně, najdi novější dokument.“ Potřebuju s ní probrat i to, jak upravit instrukce, aby příště věděla, který podklad použít a podle čeho se rozhodnout.
Na téhle průběžné práci s instrukcemi pro mě celý systém stojí a padá. Připojením konektorů technicky vyřeším přístup do nástrojů, ale tím jsem ještě AI nevysvětlil, jak pracuju. Potřebuje vědět, jak se zdroji zacházet, co z našich rozhodnutí platí a co má při práci zohlednit. Když ji budu pořád jen opravovat v jedné konverzaci a nic z toho se nepromítne do instrukcí a znalostí pro další práci, budu jí stejné věci vysvětlovat znovu.
U firmy, která potřebuje prohledávat velké množství smluv a spolehlivě najít poslední platnou revizi konkrétní dohody, budou nároky na systém jiné. Princip práce s pravidly zůstává, ale rozsah, přesnost a způsob vyhledávání už musíte řešit jinak. Pro běžné použití jednotlivce nebo menší firmy mi ale dává smysl začít tímhle jednoduchým setupem a postupně svoje AI rovnat podle toho, co od něj při práci potřebuju.
Radek OS po pár měsících
S AI systémem jsem naprosto spokojený. Ulehčuje mi práci na spoustě věcí a postupně ho ladím. Neznamená to ale, že jsem se s ním za tu dobu nepral. Je to živej organismus, který potřebuje péči, a je jen tak dobrej, jakou péči mu dávám.
Za těch několik měsíců se navíc dost rozšířil. Dnes řeším i dlouhodobé ukládání konverzací, analýzu jednotlivých běhů, spotřebu tokenů a efektivitu procesů. To už je daleko za hranicí samotného second brainu. Ten je pořád jen jednou částí většího systému, kterému říkám Radek OS.
V říjnu 2026 jsem se dostal do bodu, kdy jsem provozní databáze přesunul z Notionu do Supabase. Chvíli jsem zvažoval BigQuery, kam už můj agent měl přístup kvůli datům z marketingových systémů. Potřeboval jsem ale dotáhnout i souběh práce na dvou počítačích: jednom, který mi funguje jako server, a druhém, na kterém běžně pracuju. Podobné úlohy totiž můžou běžet na obou zároveň. Nakonec jsem pro tuhle část Radek OS zvolil Supabase a se současným rozsahem se pohodlně vejdu do jeho bezplatných limitů.
Na problém s rychlostí jsem narazil třeba při jednom větším běhu přípravy článků. Moje workflow obsahuje několik revizí, které mají texty posouvat dál, takže jsem se po přibližně patnáctihodinovém běhu podíval, co vlastně zabralo tolik času. Kolik trvalo psaní, kolik revize a kolik komunikace s jednotlivými nástroji. Zjistil jsem, že asi pět a půl hodiny z toho byla komunikace s Notionem. To je pro tenhle způsob práce blbý. Spuštění dalších agentů by samo o sobě nepomohlo, protože by stejně čekali na čtení a zápisy do Notionu.
Po migraci a souvisejících úpravách teď u srovnatelných operací proti Supabase počítám přibližně s pěti minutami místo původních pěti a půl hodiny. Těch pět minut se týká komunikace s databází, ne celého původního běhu. Kvalitnější výstupy mi samotná změna úložiště nepřinesla, ale výrazně zkrátila čas potřebný na práci s uloženými informacemi. U spotřeby tokenů nemám rozdíl pořádně doměřený. Pokud klesla, tak podle mého dosavadního odhadu jen velmi málo.
Za to, že jsem začal v Notionu, ale ničeho nelituju. Pro mě je přirozenější do něčeho skočit, začít to používat, učit se z chyb a postupně to vylepšovat. Kdybych od začátku řešil celý systém a jeho ideální technologii, možná bych se v tom akorát zbytečně zahrabal. Notion mi umožnil začít a při práci zjistit, co skutečně potřebuju. Až když jsem narazil na konkrétní limit, měl jsem důvod řešit migraci.
Pokud si chcete second brain postavit pro sebe a naučit se s ním pracovat, začněte s tím, co už máte. Ať je to Notion nebo jiný nástroj. I s neúplnými nebo ne úplně čistými daty se dá do určité míry pracovat a postupně je zlepšovat. Když ale nemáte žádné podklady, nemáte na čem stavět. Za mě je proto lepší začít si je vytvářet co nejdřív a systém optimalizovat v průběhu cesty.
Řešíte, jak si pro sebe nebo pro firmu postavit second brain nebo vlastní AI systém kolem toho, jak pracujete? Napište mi. Půlhodinové kafe je zdarma. Rád s vámi proberu, co už máte, co právě řešíte a co by šlo vylepšit. Pokud to bude v mých silách, rád vám pomůžu.