AI agent může přijmout otázku, najít data, napsat dotaz a vrátit odpověď. Pro vedení je lákavé dostat výsledek bez čekání na datový tým. Aby se podle něj dalo rozhodnout, potřebuje agent také pravidla, podle kterých firma čísla počítá a používá.
Agent nenahrazuje ETL: datové toky dál přivádějí a připravují data. Mění se práce nad nimi. V tomto článku slovem agent označuji model, který podle cíle, instrukcí a oprávnění volí kroky a používá nástroje. U dat může například dohledat definici, spustit SQL a připravit odpověď ke kontrole.
V práci s agenty považuji za základ dobře postavenou otázku. Pokud zadám vágní úkol a agent nemá potřebný kontext, nemůžu čekat spolehlivou odpověď. Má také poznat, co ještě potřebuje vyjasnit, a doptat se. Testování proto začíná už u toho, zda porozuměl zadání.
Začněme otázkou: kolik máme objednávek?
Na vymyšleném příkladu si ukážeme, proč ani jednoduchá otázka nemusí mít samozřejmou odpověď. Model může napsat syntakticky správný dotaz:
SELECT COUNT(order_id)
FROM orders
Ten spočítá neprázdné hodnoty order_id. Neříká však, zda firma potřebuje počet řádků, nebo jedinečných objednávek. Neřeší storna ani prodejní kanál.
Pro náš příklad zvolme tabulku potvrzených nákupů a pravidlo: počítáme jedinečné online objednávky, které nejsou zrušené. Pro tento rozsah by dotaz vypadal takto:
SELECT COUNT(DISTINCT order_id)
FROM orders
WHERE order_status <> 'canceled'
  AND order_stream = 'online'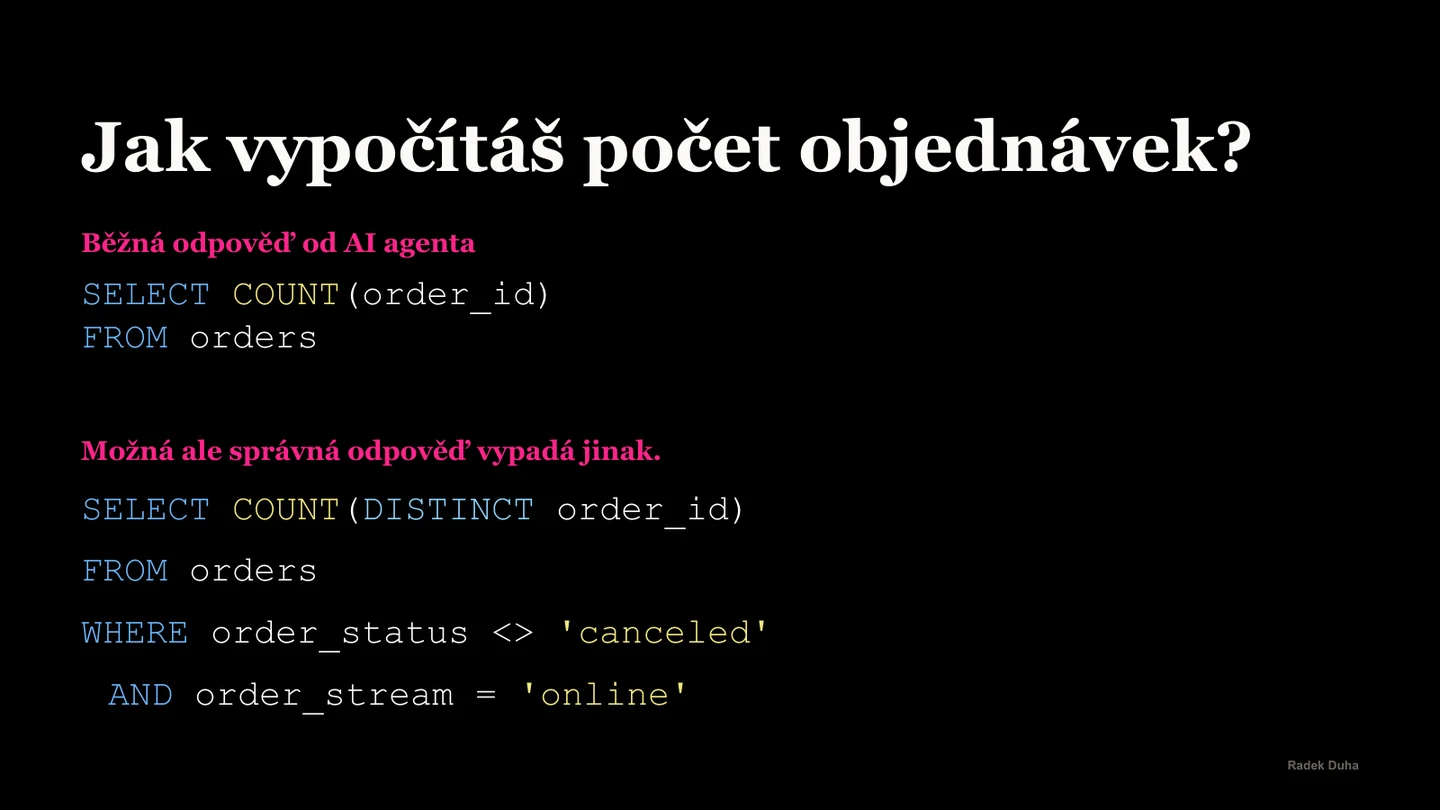
Je to zjednodušená ukázka, nikoli hotový dotaz pro libovolnou firmu. Pro časový report by bylo potřeba doplnit období a rozhodnout, podle kterého data objednávka do období patří. Tým musí také vědět, jak zachází s chybějícími stavy a pozdějšími opravami.
Pokud pravidlo zná jen seniorní analytik, agent je nemá odkud převzít. Může se doptat, nebo začne odhadovat. Chybějící definice je problém prostředí; zároveň potřebujeme ověřovat i model, který může udělat chybu navzdory dobrým podkladům.
Definici uložte vedle výpočtu
Pro důležitou metriku zapište význam, zdroj, výpočet, filtry a výjimky. Přidejte vlastníka, který vyjasní nejednoznačné pravidlo, a informaci o tom, kde se metrika používá. Definice má být dostupná lidem i agentovi.
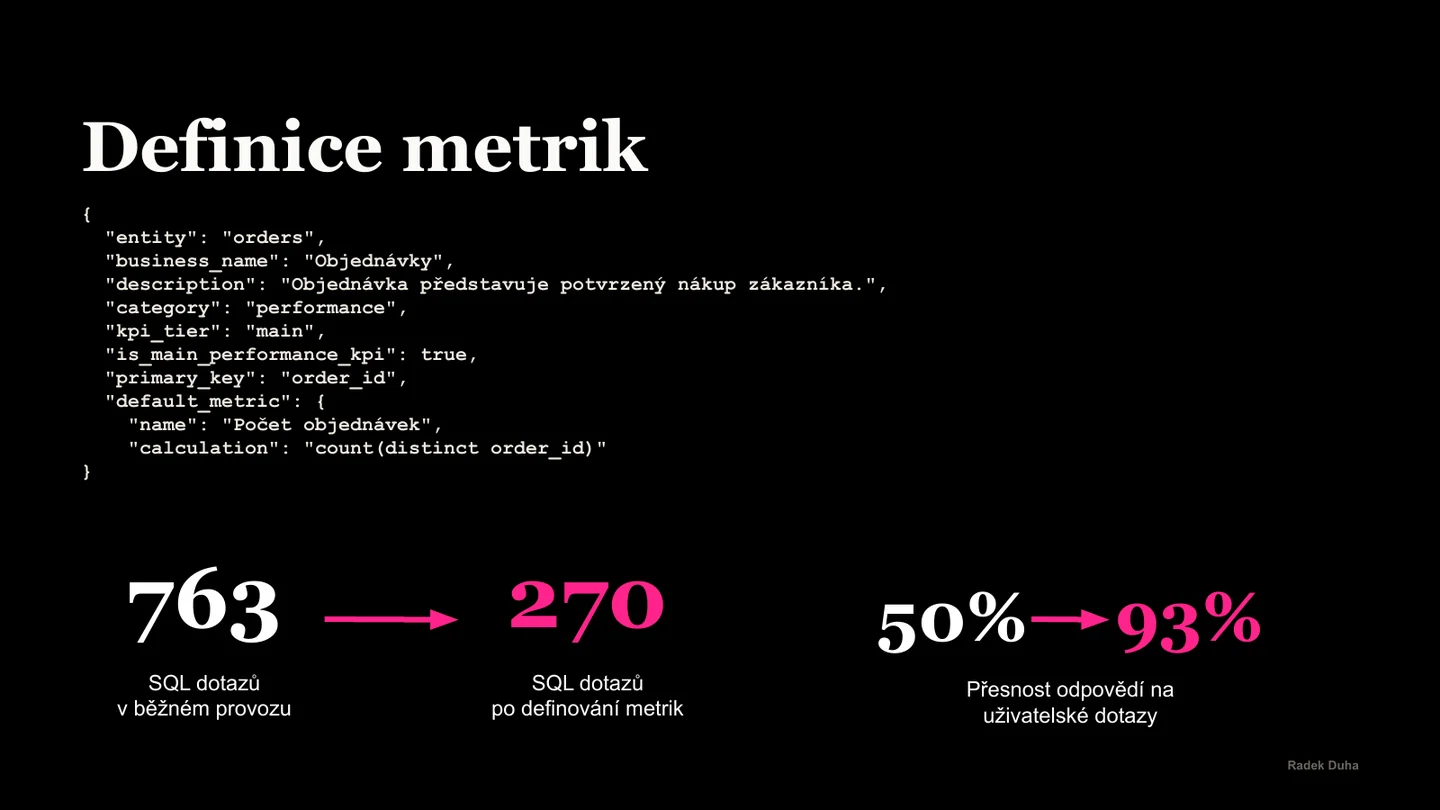
Tento vymyšlený výřez odpovídá SQL výše. Záměrně obsahuje také oba filtry. Není to univerzální formát ani ukázka nasazeného systému:
{
  "entity": "orders",
  "business_name": "Objednávky",
  "description": "Objednávka představuje potvrzený nákup zákazníka.",
  "primary_key": "order_id",
  "default_metric": {
    "name": "Počet objednávek",
    "calculation": "count(distinct order_id)",
    "filters": {
      "order_status": { "not_equal": "canceled" },
      "order_stream": { "equal": "online" }
    }
  }
}
Vzorec je jen část dohody. U marže například potřebujete určit zahrnuté náklady, dopravu, slevy, vratky a marketplace poplatky. Obecná znalost modelu nenahradí rozhodnutí firmy o tom, jak tyto položky počítat.
K číslu patří také účel otázky
Rozšiřme příklad: „Jak si vedlo Slovensko v prvním čtvrtletí proti loňsku?“ Nejdřív je potřeba vědět, zda se ptáme na objednávky, tržby, nebo marži. A zda Slovensko označuje trh, zemi zákazníka, doručovací adresu, či účetní jednotku. To jsou různé výběry dat.
Nejde o anonymizovaný klientský příběh, ale o modelovou situaci. Obchod, marketing, logistika a finance mohou pro svou práci potřebovat odlišné pohledy. Agent musí zjistit, který odpovídá konkrétnímu rozhodnutí.
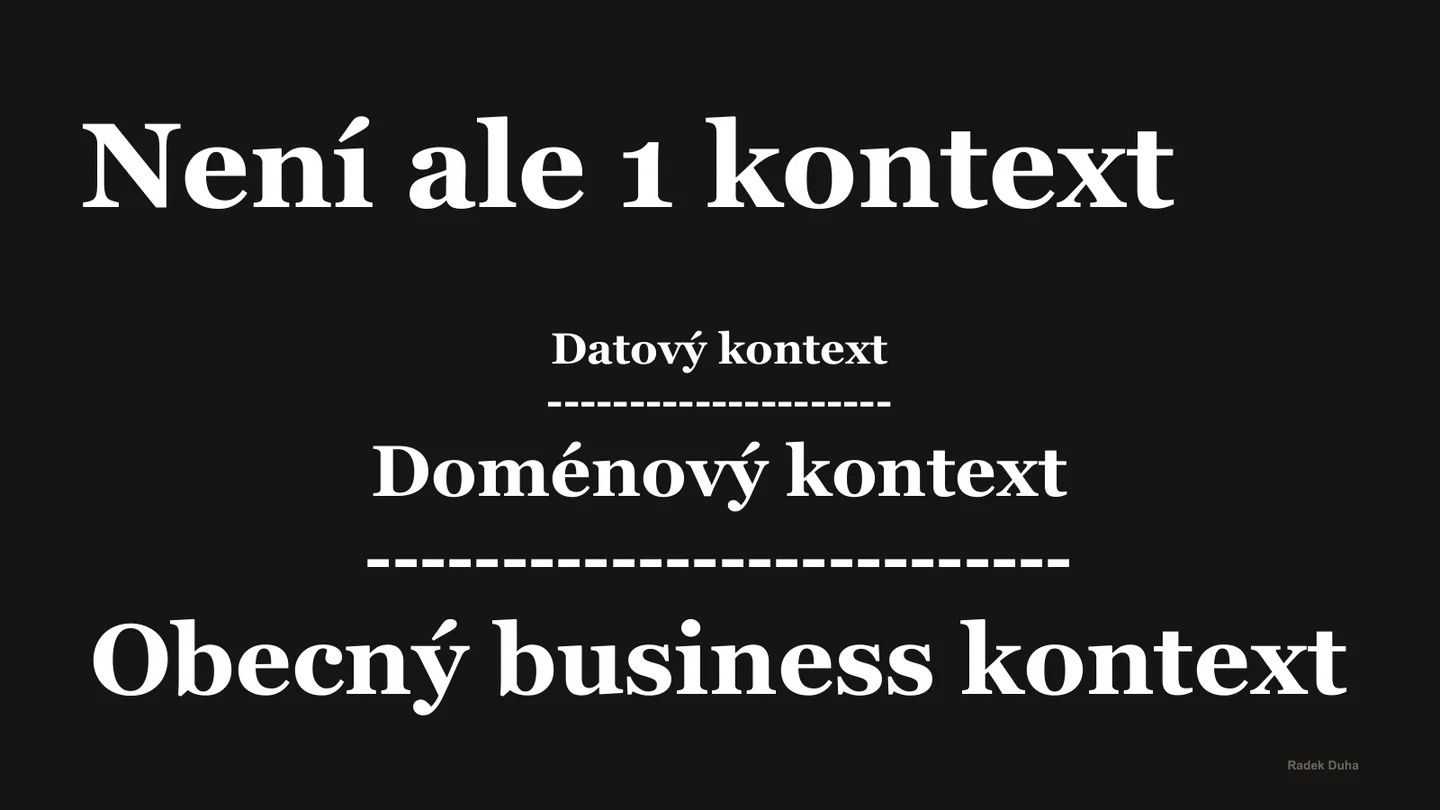
Tady se propojují tři druhy kontextu:
- Business kontext: co firma chce zjistit a proč o tom rozhoduje právě teď.
- Doménový kontext: co řeší daný tým a jak používá své nástroje a reporty.
- Datový kontext: které metriky, tabulky, filtry, měny a časová pravidla odpovídají otázce.
Pomáhá mi přirovnání k novému kolegovi. Analytikovi také nestačí ukázat databázi. Potřebuje poznat platné definice, historické tabulky a člověka, kterého se může zeptat. Stejné podklady musíme zpřístupnit agentovi. Když čekáme na jediného člověka, který pravidlo zná, prvním krokem je pravidlo zapsat.
Co má datový tým připravit
Nemusí vzniknout jeden dlouhý dokument o celé firmě. Pro vybranou otázku potřebujete dohledatelnou cestu od definice ke zdrojům a výsledku. Začal bych těmito částmi:
Ukažte, která data použít a co znamenají
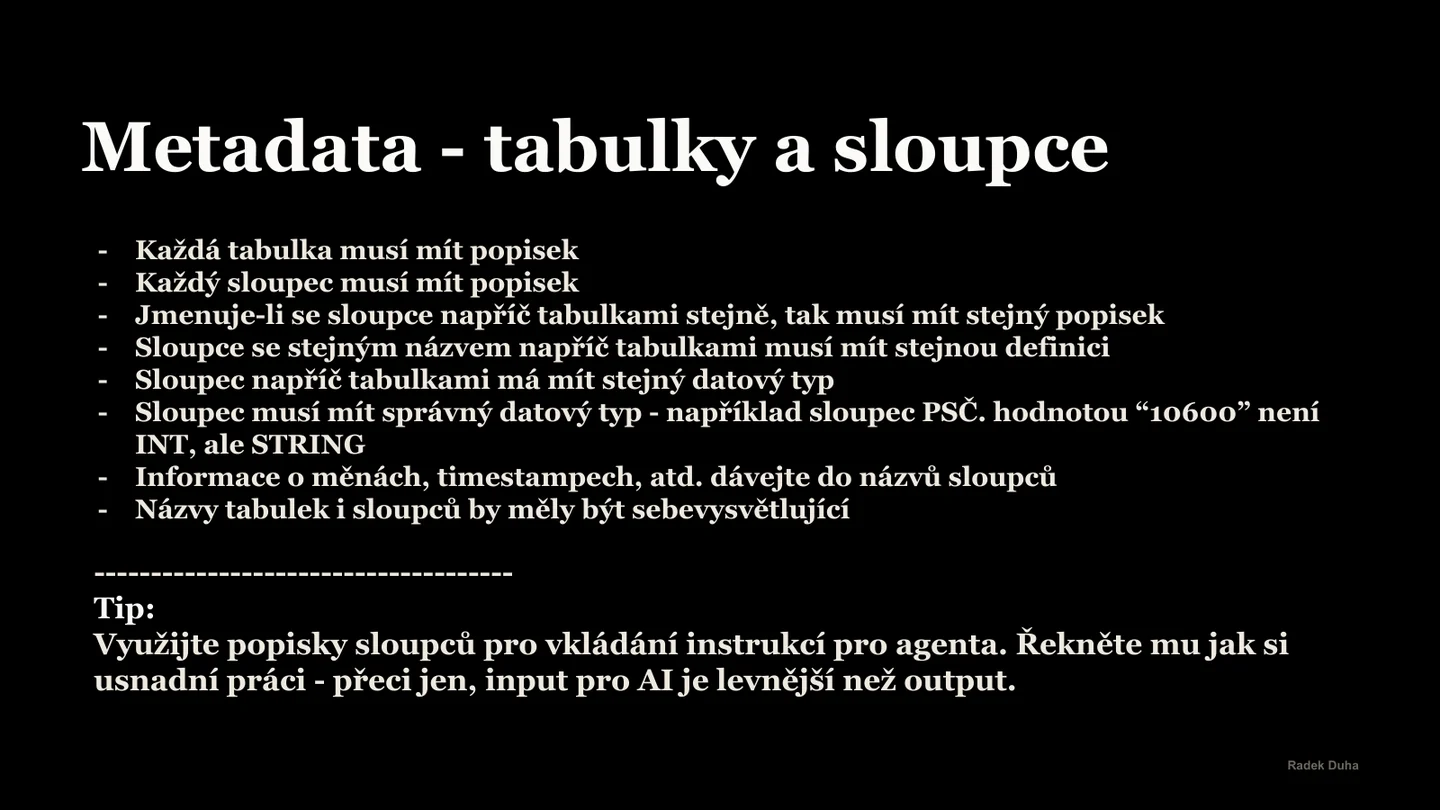
Ukažte, co je původní zdroj, co pracovní mezivýsledek a co tabulka určená pro reporting. Popište vztahy a klíče, podle kterých se data spojují. Názvy a popisky mají vysvětlit význam sloupců; stejně pojmenované položky by neměly bez upozornění znamenat různé věci.
Například PSČ není celé číslo jen proto, že obsahuje číslice. U částky potřebujeme měnu a u času časové pásmo. U vratky pravidlo, zda patří do období původní objednávky, nebo jejího zpracování. Volbu musí určit firma a uložit ji k definici.
Vymezte, co agent smí číst a měnit
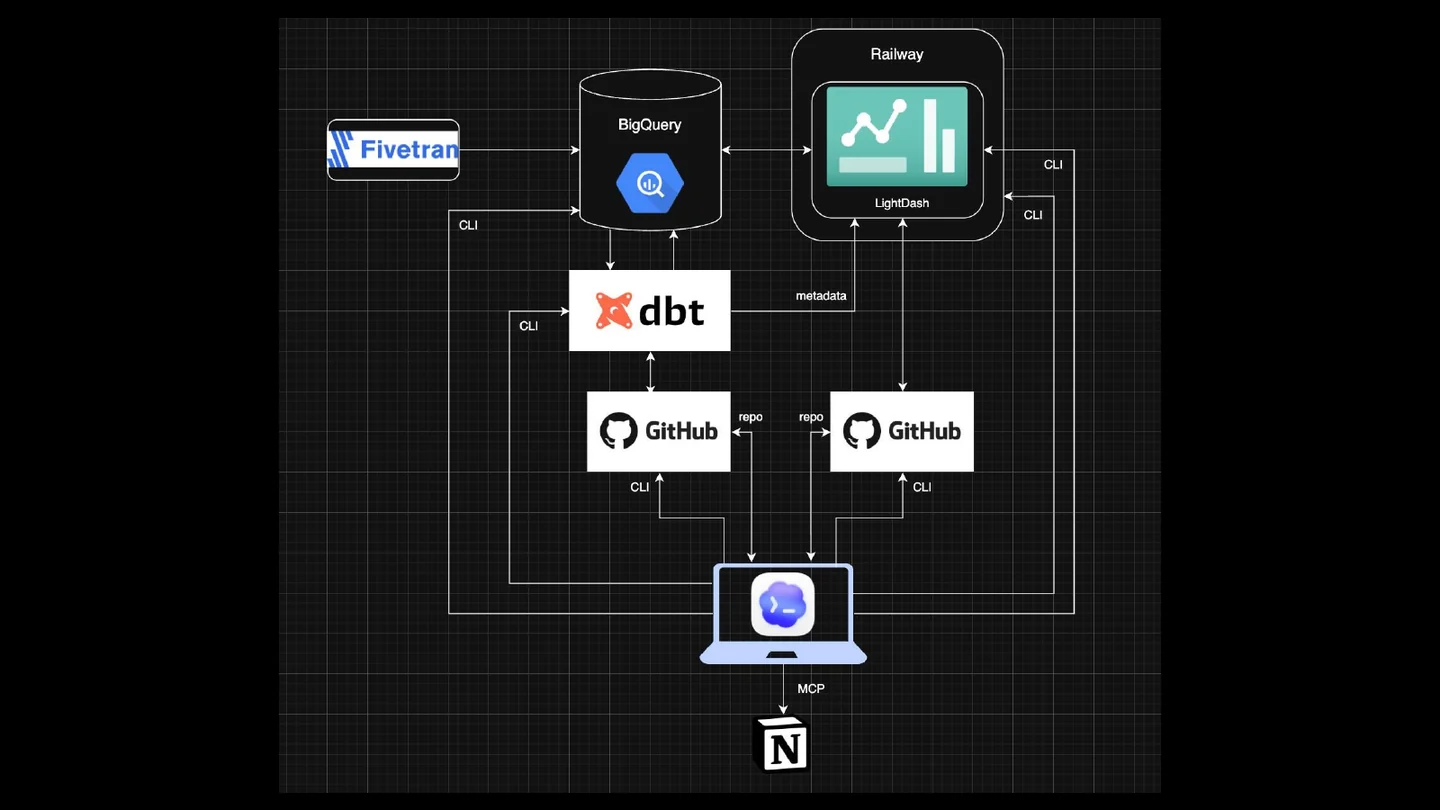
Agent potřebuje vědět, kde spustit dotaz, najít testy a přečíst logy. Určete, co smí jen číst a kterou změnu musí předat ke schválení. API, příkazový řádek a MCP mohou zpřístupnit opakovatelnou práci. U změn souborů pomáhá verzování a kontrola rozdílu, například přes GitHub a CI.
Při výběru nástroje ověřte konkrétní dostupné operace. Ovládání prohlížeče může posloužit, ale pro opakované úlohy bývá obtížnější udržet stabilní postup a záznam provedených kroků. Samotná existence API také spolehlivost nezaručuje.
Ověřte odpověď i cenu potřebných pokusů
Vedle testů dat připravte otázky s očekávanými odpověďmi, včetně výjimek. Tyto evaluace mají ověřit nejen výpočet, ale i použití kontextu: poznal agent nejasnou otázku, použil platné pravidlo a odpověděl na to, co firma řeší? Změnu modelu, definice nebo postupu ověřte na stejných příkladech. Dohody mezi zdrojem, transformací a reportem mají určit, jaká data si předávají a co musí kontrola zachytit.
Dobrý kontext může omezit zbytečné pokusy, ale nižší počet dotazů či tokenů není zaručený. Získání kontextu také něco stojí. Měřte počet pokusů, celkové náklady a lidské opravy na jednu použitelnou odpověď. Více dotazů kvůli většímu počtu otázek je jiná situace než desítky neúspěšných pokusů nad jediným úkolem.
Z kontroly má vzniknout lepší další odpověď
Na začátku má člověk z datového týmu zkontrolovat otázku, dotaz i odpověď. Správná syntaxe nestačí: výsledek musí odpovídat definici a rozhodnutí, pro které vznikl. Míru další kontroly nastavte podle spolehlivosti úlohy a následků chyby.
Když se objeví problém, neopravujte jen komentář. Chybějící filtr patří do dotazu, nejasný význam do definice a nový hraniční případ do testů. Pokud se mění firemní pravidlo, zaznamenejte rozhodnutí a datum platnosti. Příští úkol má využít tuto opravu.
Takto chápu budování kontextu: jako dlouhodobou práci, při které se zjištění z výstupů vracejí do podkladů a evaluací. Jednou napsaný dokument nemůže pokrýt všechny budoucí otázky ani změny firmy.
Tím chráníte i důvěru lidí v data. Přesvědčivě napsaná chybná odpověď může poškodit víc než jednu poradu. Člověk proto potřebuje vidět zdroj, omezení a způsob, jak chybu napravit.
První krok: jedna otázka od zadání po ověření
První pravidla bych vybíral podle procesu, který chceme zlepšit. Zajímá mě, kde firmu problém nejvíc tlačí, co ji stojí nejvíc peněz nebo kde vznikají hlavní příjmy. Hledám buď úsporu práce a nákladů, nebo možnost vytvořit další hodnotu. Jedno univerzální pravidlo pro všechny firmy nemám.
Z tohoto místa vyberte jednu otázku, na kterou dobrý analytik umí odpovědět a jejíž výsledek někdo využije. Nemusíte předem zdokumentovat celý sklad. Potřebujete dostatečně malý rozsah, aby šlo zjistit, zda agent úkol zvládl.
- Vyberte rozhodnutí. Zapište otázku, komu má odpověď sloužit a co podle ní udělá.
- Uložte pravidla. Definice, filtry, výjimky, vlastník a odkazy na zdroje mají být dohledatelné.
- Připravte data a přístup. Popište potřebné tabulky, spoje, typy, měny a časy. Vymezte oprávnění.
- Domluvte ověření. Určete očekávaný výsledek, obtížné případy a člověka, který posoudí odpověď. Tým uchovává historii změn a kontroluje je.
- Projděte celý úkol. Sledujte výsledek, náklady a lidské opravy. Zjištění vraťte do definic, postupu a testů.
Až tento postup funguje, rozšiřte sadu například na deset běžných otázek a jejich výjimky. Počet berte jako výchozí návrh, nikoli důkaz připravenosti celé firmy. Další rozsah má vycházet z ověřených výsledků.
Pokud řešíte propojení dat, metrik a AI, můžeme projít architekturu datových a AI systémů. Pro společné zadání s týmem je tu workshop Od ETL k AI agentům. Jestli zatím neznáte příčinu nespolehlivých čísel, začněte datovým auditem.